
Целостность и хэш-функции
Целостность информации означает, что изменять ее могут только лица, обладающие соответствующими полномочиями. Задача обеспечения целостности данных заключается в том, чтобы обнаружить любую несанкционированную модификацию данных при их передаче или хранении. Другими словами, получатель сообщения может с уверенностью утверждать, что оно доставлено именно в том виде, в котором было отправлено, либо констатировать факт его искажения.
Шифрование само по себе не обеспечивает целостность сообщения
Интуитивно кажется, что если злоумышленник не знает открытого текста, то он не способен осмысленно изменить и соответствующий ему шифртекст. На практике это неверно. Причина состоит в том, что большинство алгоритмов шифрования являются детерминированными преобразованиями данных. Любое изменение шифртекста приводит к некоторому изменению результата дешифрования. Совсем не обязательно, чтобы злоумышленник понимал, каким именно окажется это изменение. Для нарушения безопасности достаточно уже того факта, что получатель примет измененное сообщение как подлинное.
Предположим, Алиса отправляет Бобу (банковской программе) распоряжение перевести на счет Евы 1000$ и зашифровывает это сообщение с помощью самого надежного шифра в мире – одноразового блокнота с однократно используемым ключом. Ева перехватывает сообщение и хочет изменить его таким образом, чтобы на ее счет была переведена другая сумма, например, 9000$. На первый взгляд, она не может сделать этого, не зная ключа: ведь без ключа ей не удастся ни дешифровать исходное сообщение, ни зашифровать свое собственное сообщение, чтобы оно было принято банком. Однако на самом деле все, что нужно Еве – это определить, в каком именно месте сообщения содержится сумма перевода (если Боб – стандартизированная программа, придерживающаяся определенного протокола, включающего структуру сообщений). Пусть m1 – участок зашифрованного сообщения m, в котором содержится зашифрованная сумма. Т.е. m = m0 | m1 | m2. (Здесь и далее | – операция объединения строк.) Чтобы изменить эту сумму и получить на выходе корректное зашифрованное сообщение, которое примет банк, Еве нужно проделать простую операцию:
m1′ = m1 ⊕ 10002 ⊕ 90002
m′ = m0 | m1′ | m2
Проблема в том, что большинство шифров разрабатывались, чтобы обеспечивать конфиденциальность информации, а не ее целостность. Для этого понадобятся иные примитивы.
6.1. Коды аутентификации сообщений (MAC)
Все средства обеспечения целостности подчинены одной идее – свернуть сообщение произвольной длины в короткую строку фиксированной длины так, чтобы подобрать к этой строке другое сообщение было практически невозможно. На основе сообщения по некоторому алгоритму вычисляется величина (последовательность бит), которую в зависимости от алгоритма называют по-разному (контрольной суммой, электронной подписью, хэшем и т.д.), мы будем использовать общее название – тег. Этот тег отправляется вместе с сообщением. Получатель сообщения выполняет процедуру проверки. Процедура проверки сообщает, было ли сообщение изменено в процессе передачи.
Коды аутентификации сообщений (Message Authentication Code – MAC) для генерации тега и проверки его валидности используют секретный ключ, известный отправителю и получателю.
Таким образом, MAC I – это набор из двух функций, одна из которых называется функцией генерации тега S, а вторая – функцией проверки V. Первая функция принимает на входе сообщение m и секретный ключ k и возвращает тег t. Вторая функция принимает на входе сообщение, секретный ключ и тег и возвращает true, если тег прошел проверку на подлинность и false в противном случае. Если ввести следующие обозначения:
X – множество всевозможных сообщений,
K – множество всевозможных ключей,
T – множество всевозможных тегов,
то MAC можно задать следующими соотношениями:
I = (S, V);
S: K×X → T;
V: K×X×T → {true, false};
V(k, m, S(k, m)) = true;
Последнее означает, что если функция получает для проверки сообщение m, ключ k и тег, сгенерированный для этой пары сообщение/ключ, то, очевидно, она должна вернуть значение true (см. рис. 6.1).
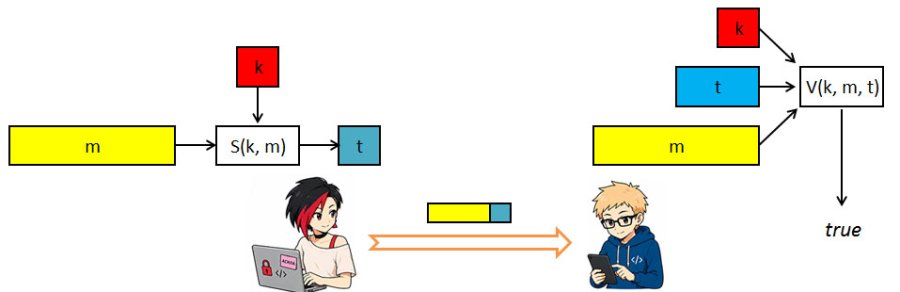
Рис. 6.1. Схема использования MAC
Для определения надежности MAC предполагается, что противник обладает следующими возможностями:
1) Противнику известны детали реализации функций S и V.
2) Противник может заставить отправителя сгенерировать теги для любого количества специально подобранных им сообщений (разновидность атаки с избранным открытым текстом). Другими словами, он имеет q пар (m, t), созданных с использованием одного и того же ключа k.
Целью противника является подделка. Подделкой называется такая пара (m′, t′), что V(k, m′, t′) = true (пара принимается как валидная), и она не входит в число q пар, наблюдаемых противником ранее – то есть, создана без знания ключа k (рис. 6.2.). MAC будет считаться надежным, если для любого вычислительно эффективного алгоритма вероятность генерации такой пары ничтожно мала.
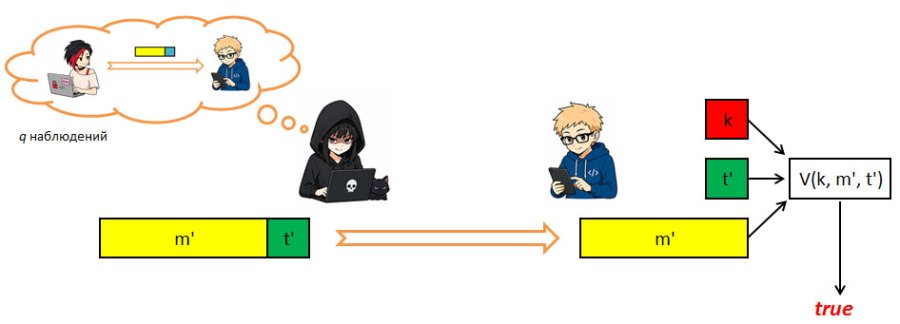
Рис. 6.2. Подделка MAC
Рассмотрим способы построения MAC
1. Если у нас есть надежный алгоритм шифрования (например, блочный шифр AES), то мы можем использовать его непосредственно в качестве функции генерации тега. Другими словами, в качестве тега будет выступать само сообщение, зашифрованное секретным ключом K с помощью надежного алгоритма шифрования E.
S(k, m) = E(k, m)
Функция проверки подлинности будет работать следующим образом:
V(k, m, t) = (t == E(k, m))
Если результат шифрования полученного сообщения m с ключом kсовпадает с полученным тегом t, то пара <m, t> принимается. С высокой долей вероятности сообщение подлинно, то есть, создано вторым владельцем секретного ключа. Никто не смог бы вычислить E(m, k), не зная k, даже если бы он наблюдал перед этим множество других пар <m, E(m, k)> – при условии, что шифр E надежный.
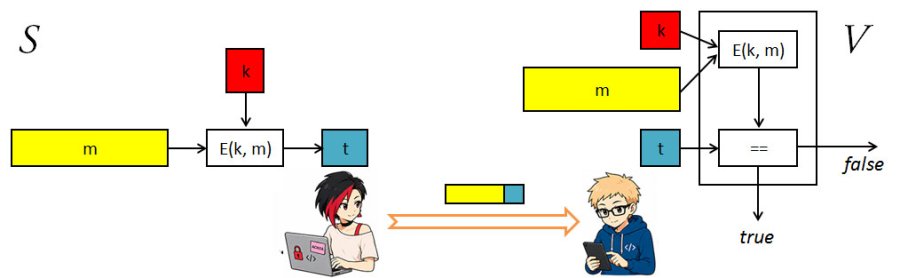
Рис. 6.3. MAC на основе симметричного алгоритма шифрования
Недостаток этого способа состоит в том, что блочный шифр оперирует блоками небольшой длины. Удобно таким образом вычислить MAC для короткого 128-битного сообщения, но в реальной жизни приходится подписывать сообщения произвольной длины. Если же воспользоваться потоковым шифром или одним из режимов шифрования, то мы получим очень длинный тег – такой же, как само сообщение. Очевидно, удваивать каждый раз размер пересылаемого текста не оптимально.
2. Для шифрования сообщений произвольной длины можно построить более сложную конструкцию, базовым элементом которой снова будет являться симметричный алгоритм шифрования E. Рассмотрим две наиболее популярные конструкции:
ECBC-MAC. Похож на режим сцепления шифрованных блоков. Основная разница заключается в том, что все блоки шифртекста кроме последнего (в создании которого приняли участие все остальные) отбрасываются, а этот последний блок проходит дополнительный этап шифрования с отдельным ключом k1 (т.е. ключ ECBC-MAC в два раза больше ключа алгоритма шифрования E и состоит из двух подключей k0 и k1). Схема вычисления MAC наглядно представлена на рис. 6.4.
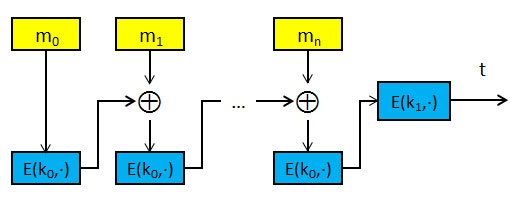
Рис. 6.4. ECBC-MAC
NMAC. Основная идея та же самая: каждый предыдущий блок текста после шифрования воздействует на следующий. Только теперь они не складываются друг с другом, а связываются по ключу: результат каждого предыдущего шага шифрования служит ключом для следующего (см. рис. 6.5.). Очевидно, что для этого размер выходного блока алгоритма E должен совпадать с размером ключа этого алгоритма.
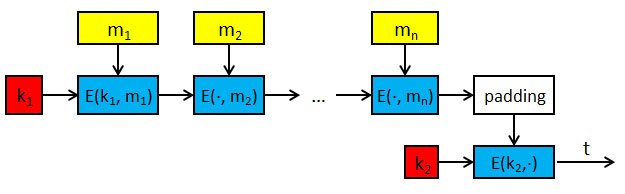
Рис. 6.5. NMAC
Во всех приведенных схемах вычисление MAC производится только в прямом порядке. Когда получатель проверяет валидность пары <сообщение, тег>, он вычисляет MAC для сообщения и сравнивает его с пришедшим тегом. Если они совпадают, пара принимается. Функция дешифрования D вообще не используется. Следовательно, в общем случае мы можем заменить алгоритм E на псевдослучайную функцию F (главное отличие заключается в том, что F не обязана быть обратимой, и размер выхода может быть меньше размера входа). Именно поэтому в схеме NMAC появляется этап, называемый дополнением (padding) – если выход функции F меньше, чем ключ, то он дополняется до нужного размера определенной последовательностью бит, после чего применяется последний раунд шифрования с отдельным ключом k2.
Последний раунд шифрования с другим ключом k2 является обязательным для защиты от подделки. Предположим, этого этапа бы не было. Тогда, перехватив пару <m, t>, противник смог бы сгенерировать MAC для любого своего сообщения, начинающегося с m, поскольку будет наблюдаться следующее соотношение:
S(k, m | m1) = S(S(k, m), m1).
Приведенные схемы наглядно демонстрируют процедуру построения MAC для сообщения произвольной длины в случае, когда длина сообщения кратна размеру блока. Если это не так, то последний блок сообщения будет короче, чем принимает на входе алгоритм шифрования E (или псевдослучайная функция F). В этом случае сообщение дополняют определенной последовательностью бит до требуемого размера. Главное при этом, чтобы два разных сообщения после дополнения не стали одинаковыми. В этом случае их MAC будут равны, чем не замедлит воспользоваться злоумышленник.
Предположим, мы решили дополнить сообщение до нужной длины нулевыми битами. Тогда, перехватив MAC сообщения «001», противник будет знать MAC для сообщений «0010», «00100», «001000» и т.д. – ведь они будут одинаковыми. А наличие такой возможности делает MAC небезопасным.
В большинстве современных стандартов используется дополнение вида «1000…0». Т.е. в конец сообщения дописывается бит «1», а затем – нужное количество нулевых битов до кратной длины. Если же длина сообщения изначально кратна длине блока, то в конец сообщения добавляется целый блок вида «1000…0». Тогда любые два различных сообщения после дополнения не будут совпадать.
6.2. Хэш-функции
В общем случае хэш-функция H: X → T преобразует сообщение (битовую последовательность) произвольной длины в выходную строку фиксированной длины, называемую хэшем. Как правило, размер выхода намного меньше размера входа (результат хэш-функции порядка нескольких сотен бит, в то время как исходное сообщение может занимать мегабайты). Хэш-функция не зависит от ключа и для одного и того же сообщения всегда генерирует один и тот же хэш.
Ситуация, когда для двух разных сообщений m1 ≠ m2 их хэши совпадают, т.е. H(m1) = H(m2), называется коллизией.
Криптографию интересуют особые хэш-функции, обладающие рядом специальных свойств:
- Односторонность (необратимость). Для любого h должно быть практически невозможно вычислить или подобрать такое x, что H(x) = h.
- Стойкость к коллизиям первого рода. Для любого сообщения x должно быть практически невозможно вычислить или подобрать другое сообщение y, такое что H(x) = H(y).
- Стойкость к коллизиям второго рода. Должно быть практически невозможно вычислить или подобрать любую пару различных сообщений x и y, для которых H(x) = H(y).
Такие хэш-функции называются криптостойкими.
Стойкость к коллизиям второго рода – самое сильное из трех требований: если противник не может отыскать ни одной пары совпадающих сообщений вообще, то тем более он не подберет пару к заранее заданному сообщению. Обратное неверно: существуют функции, для которых подобрать пару к конкретному сообщению трудно, а найти какую-нибудь произвольную пару легко. Односторонность стоит несколько особняком и из стойкости к коллизиям в общем случае не следует, хотя у функций, применяемых на практике, обычно выполняются все три свойства сразу.
Практический смысл этой иерархии в том, что разным применениям требуются разные свойства. Когда хэш дистрибутива публикуется, чтобы всякий мог проверить, не подменен ли скачанный файл, достаточно стойкости к коллизиям первого рода: противник вынужден подбирать замену к уже существующему, не им созданному файлу. Но когда хэш документа подписывается электронной подписью, необходима стойкость к коллизиям второго рода: злоумышленник может сам изготовить два документа с одинаковым хэшем – безобидный и мошеннический, – дать подписать первый и предъявить полученную подпись вместе со вторым.
Разница в стоимости этих задач для противника видна из простого подсчета. Чтобы подобрать сообщение к заданному хэшу длины n бит, требуется порядка 2ⁿ попыток. Чтобы найти произвольную пару совпадающих сообщений, достаточно около 2n/2 – это следствие парадокса дней рождения. Разница огромна: для 128-битного хэша это 2¹²⁸ против 2⁶⁴. Поэтому длину хэша всегда выбирают с расчетом на второй, более дешевый для противника сценарий, и именно поэтому 128 бит, вполне достаточные для ключа симметричного шифра, для хэш-функции уже недостаточны.
6.3. Способы построения хэш-функций
Большинство современных хэш-функций строятся по одной общей схеме, которая называется структура Меркла-Дамгарда. Идея заключается в том, чтобы, имея функцию, генерирующую хэш для блока фиксированной длины, расширить ее на сообщение произвольной длины.
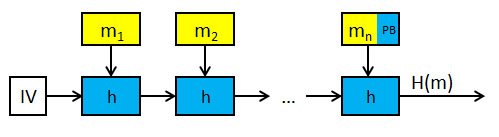
Рис. 6.6. Структура Меркла-Дамгарда
Как видно из рисунка 6.6, идея та же самая, что и в алгоритме NMAC. Главное отличие заключается в том, что вместо секретного ключа на вход конструкции подается общеизвестный и постоянный для конкретного алгоритма инициализационный вектор IV, поскольку вычислить хэш для заданного сообщения может кто угодно.
Функция h, на основе которой строится хэш-функция, называется функцией сжатия. Она строит хэш для блока фиксированной длины. Доказана теорема, что если функция сжатия h обладает стойкостью к коллизиям, то тем же свойством обладает функция H, построенная по схеме Меркла-Дамгарда.
Чтобы сообщение разбивалось на целое число блоков, его дополняют. Дополнение обычно имеет вид 10000…0 | длина сообщения (последние 64 бита).
Структура Меркла-Дамгарда дает хороший лавинный эффект: изменение малого количества бит в сообщении ведет к изменению большого количества бит в хэше.
У конструкции Меркла-Дамгарда есть свойство, которое стоит рассмотреть отдельно, поскольку оно объясняет устройство сразу нескольких дальнейших конструкций. Результат хэширования – это в точности внутреннее состояние функции после обработки последнего блока. Следовательно, зная H(m) и длину m, но не зная самого m, противник может продолжить вычисление: взять полученный хэш в качестве промежуточного состояния, добавить произвольные блоки и получить корректное значение хэша для сообщения, начинающегося с m. Эта возможность называется атакой удлинением сообщения.
Для самой хэш-функции это не изъян: ни одно из перечисленных выше свойств атакой удлинения не нарушается. Проблемы начинаются при попытке построить на такой функции код аутентификации очевидным способом, вычислив H(k | m). Противник, перехвативший одну пару из сообщения и тега, сможет получить корректный тег для сообщения, начинающегося с перехваченного, не зная при этом ключа. Вы можете узнать здесь в точности то соотношение, которым выше обосновывалась необходимость завершающего раунда с отдельным ключом в схеме NMAC. Причина одна и та же: у итеративной конструкции внутреннее состояние совпадает с выходом, и завершающее преобразование существует именно для того, чтобы их развести.
Очевидно, что функция сжатия может быть построена на основе блочного шифра, хотя использовать в качестве h просто алгоритм шифрования E не рекомендуется – алгоритмы шифрования разрабатывались для обеспечения конфиденциальности, а не сопротивляемости коллизиям. Криптографически стойкой является функция сжатия Дэвиса-Мейера, имеющая следующую простую формулу:
h(H, m) = E(m, H) ⊕ H
Обратите внимание, в качестве ключа используется блок хэшируемого сообщения, а шифруется хэш, полученный на предыдущем шаге (соответственно IV на шаге 1).
Наглядно функция Дэвиса-Мейера отражена на рис. 6.7.
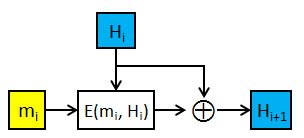
Рис. 6.7. Функция Дэвиса-Мейера
Существует 12 вариантов подобных функций, например, h(H, m) = E(H ⊕ m, m) ⊕ m и т.д. Существует также множество небезопасных вариантов, таких как h(H, m) = E(m, H) ⊕ m. Почему первый вариант безопасный, а второй нет – можете исследовать самостоятельно.
Доказано, что для идеального шифра E нахождение коллизии функции Дэвиса-Мейера потребует O(2n/²) вычислений, где n – длина хэша. Это наилучший из возможных результатов, поскольку именно таких усилий требует подбор коллизии методом грубой силы – на основе парадокса дней рождения.
На основе структуры Меркла-Дамгарда были построены известные алгоритмы хэширования семейства MD, последний из которых, MD5 широко использовался до конца 2000 годов. В настоящий момент считается устаревшим и криптографически взломанным.
Алгоритм хэширования SHA-256 построен на основе уже рассмотренных составляющих:
- структура Меркла-Дамгарда,
- функция Дэвиса-Мейера,
- в качестве блочного шифра алгоритм SHACAL-2 (интересно, что этот алгоритм шифрования был разработан на основе SHA-256, а не наоборот).
Структура Меркла-Дамгарда – не единственный способ построить хэш-функцию для сообщений произвольной длины из преобразования фиксированного размера.
В конце 2000-х годов, после того как был взломан MD5 и обнаружились слабости SHA-1, Национальный институт стандартов и технологий США объявил открытый конкурс на новую хэш-функцию – по образцу того конкурса, из которого вышел AES. Победителем в 2012 году стал алгоритм Keccak, принятый под названием SHA-3. Существенно, что он построен принципиально иначе, чем SHA-2. Смысл был не в том, чтобы получить функцию лучше прежней, а в том, чтобы иметь про запас функцию, которая не разделяет со старой ни конструкции, ни, следовательно, возможных общих слабостей.
Конструкция SHA-3 называется губкой. Алгоритм располагает внутренним состоянием, заметно большим, чем выдаваемый хэш, и это состояние разделено на две части: внешнюю, с которой взаимодействует сообщение, и внутреннюю, наружу не выдаваемую. На стадии впитывания блоки сообщения последовательно складываются с внешней частью состояния, после чего все состояние целиком перемешивается фиксированной перестановкой. Когда сообщение исчерпано, начинается стадия выжимания: из внешней части состояния считывается результат, при необходимости состояние перемешивается снова и считывается следующая порция.
Отсюда два следствия. Во-первых, атака удлинением сообщения здесь невозможна: выход не равен внутреннему состоянию, поскольку часть состояния наружу не выдается вовсе, и продолжить вычисление, зная один лишь хэш, нельзя. По этой причине для SHA-3 не требуется конструкция вида HMAC – код аутентификации получается простым хэшированием ключа вместе с сообщением. Во-вторых, длина выхода не фиксирована: стадию выжимания можно продолжать сколько угодно. Это позволяет применять ту же конструкцию не только как хэш-функцию, но и как генератор псевдослучайной последовательности или как функцию выработки ключей.
Российский стандарт ГОСТ Р 34.11–2012, известный также под названием «Стрибог», определяет две хэш-функции – с длиной выхода 256 и 512 бит, различающиеся только начальным значением и усечением результата.
6.4. Практика использования хэш-функций
Хэш-функции представляют собой один из наиболее распространенных примитивов, предназначенных для построения других примитивов (например, того же MAC) и сложных криптографических систем, но могут использоваться и для решения других разнообразных задач (например, ускорение поиска в документной базе, когда совпадения ищутся не по сравнению текстов, а по сравнению их хэшей, что намного быстрее).
Давно принято использование хэш-функций для проверки целостности информации, чтобы защитить саму информацию от передачи по небезопасному каналу связи. Например, если в системе используется аутентификация на основе пароля, введенные пароли необходимо с чем-то сравнивать. Напрашивается простая мысль создать базу, в которой хранятся пароли каждого пользователя и сравнивать с ней. Это очень плохо: если злоумышленник получит к базе доступ, вся система становится полностью скомпрометирована.
Практическим стандартом проектирования является хранить не сами пароли, а их хэши. В этом случае похищение базы не даст злоумышленнику готовых паролей, ведь свойства хэш-функции не позволяют получить по хэшу подходящий пароль.
Тем не менее, злоумышленники могут использовать хитрую тактику: вычислить хэши для нескольких тысяч популярных паролей, после чего поискать в базе совпавшие значения (атака по словарю). Если пользователи этой системы сами придумывают себе пароли, совпадения непременно найдутся. Более того, можно составить специальные таблицы с хэшами известных паролей. Такие таблицы, оптимизированные по объему за счет объединения паролей в цепочки и хранения только начала и конца каждой, называются радужными таблицами. Популярных алгоритмов хэширования не так много, они не зависят от ключа или иной информации, значит, хэш определенного пароля или сообщения всегда одинаков, следовательно, таблицы (в них войдут хэши для коротких паролей, слов естественных языков, популярных символьных комбинаций и т.д.) можно построить заранее и использовать многократно. Можно даже скооперироваться для заполнения таких таблиц и вообще не начинать с нуля, а использовать уже существующие.
Для защиты от радужных таблиц применяется хитрость: хранение хэшей паролей с солью. Перед хэшированием к паролю добавляется несколько случайных символов (соль), т.е.
h = H(password | salt)
Это уже более надежный вариант. Подобрать пароль с помощью таблиц таким методом не получится. Для каждого пароля используется своя соль, поэтому, по сути, радужную таблицу необходимо генерировать для каждого пользователя (т.е. задача становится вычислительно сложной). Особенно если использовать при этом медленную функцию хэширования – да, некоторые алгоритмы хэширования специально делают очень медленными, чтобы максимально затруднить злоумышленнику поиск строки, дающей нужный хэш. Например, алгоритм Bcrypt имеет настраиваемый параметр, влияющий на скорость.
Отметим, что описанная формула передает лишь ключевую идею, ее не следует использовать «в лоб» и вообще мы не рекомендуем изобретать как своих шифров, так и собственных конструкций из хэш-функции и соли. Для хранения паролей существуют специальные функции выработки ключа, куда пароль и соль подаются как отдельные параметры.
Важнее понять, что соль и медленность решают две разные задачи и друг друга не заменяют. Соль обесценивает заранее вычисленные таблицы: поскольку у каждого пользователя она своя, готовую таблицу использовать нельзя, а строить ее заново ради одного пароля невыгодно. Но соль нисколько не мешает противнику перебирать пароли конкретного пользователя, ведь она хранится рядом с хэшем и потому ему известна. От перебора защищает только высокая стоимость одного вычисления, и задает ее настраиваемый параметр сложности. Разумная его величина выбирается так, чтобы проверка пароля занимала на сервере время, незаметное человеку, но неприемлемое при переборе миллиардов вариантов. Отсюда следует, что этот параметр приходится время от времени увеличивать: оборудование противника дешевеет.
История хэш-функций дает лучшую в криптографии иллюстрацию важного тезиса:
Стойкость примитива – величина, убывающая со временем
Алгоритм MD5, опубликованный в 1992 году и выдающий 128-битный хэш, уже к концу 1990-х вызывал теоретические сомнения; в 2004 году для него был опубликован практический метод поиска коллизий, а вскоре нахождение пары сообщений с совпадающим хэшем стало занимать секунды на обычном компьютере. Академическим упражнением это быть перестало в 2012 году, когда обнаружилась вредоносная программа, распространявшаяся под видом обновления операционной системы: ее авторы подобрали коллизию к сертификату удостоверяющего центра, все еще использовавшего MD5, и получили тем самым подпись, подлинную с точки зрения системы. Заметим, что ни один ключ при этом скомпрометирован не был и ни один шифр не был вскрыт.
Алгоритм SHA-1 со 160-битным хэшем прошел тот же путь медленнее. Оценки, показавшие, что поиск коллизии дешевле полного перебора, появились в 2005 году; браузеры и удостоверяющие центры начали отказываться от SHA-1 около 2014 года – задолго до того, как атака стала практически осуществимой. Первая реальная коллизия была предъявлена в 2017 году: два различных документа PDF с одинаковым хэшем. Вычисления потребовали ресурсов, доступных крупной корпорации.
Из этих историй стоит извлечь три вывода. Первый: между обнаружением теоретической слабости и практической атакой проходят годы, и это единственное время, отпущенное на замену алгоритма; кто начинает переход после появления практической атаки, опаздывает необратимо. Второй: примитив выходит из употребления не мгновенно – MD5 продолжал встречаться в работающих системах спустя годы после взлома, и жертвами становятся именно эти отставшие системы. Третий, и главный: обе атаки были атаками на коллизии второго рода, то есть требовали от противника возможности изготовить оба документа самому. Но именно такая возможность есть у всякого, кто подает документ на подпись, – и потому свойство, кажущееся самым абстрактным из трех, оказалось самым важным на практике.
Отметим и обратную сторону. MD5 и SHA-1 сломаны в отношении коллизий, но не в отношении односторонности: восстановить сообщение по его хэшу MD5 по-прежнему невозможно. Фраза «алгоритм взломан» бессодержательна, пока не сказано, какое именно его свойство нарушено.
6.5. MAC на основе хэш-функции
Если скомбинировать сообщение с секретным ключом и применить к этой комбинации функцию хэширования, то мы получим MAC, генерирующий тег фиксированной длины для сообщения произвольной длины. Самый распространенный алгоритм построения MAC на основе хэш-функции называется HMAC. В нем используется следующая формула:
S(k, m) = H((k ⊕ opad) | H((k ⊕ ipad) | m))
Здесь opad и ipad – два фиксированных битовых блока, которые накладываются на ключ и по сути порождают два разных ключа из одного.
HMAC – наиболее часто используемый алгоритм в интернет-протоколах.
Обратим внимание на то, почему в этой формуле хэш-функция применяется дважды, а не один раз. Очевидная конструкция H(k | m) непригодна из-за атаки удлинением сообщения, разобранной выше: перехватив одну пару из сообщения и тега, противник сможет вычислить корректный тег для более длинного сообщения. Внешнее хэширование эту возможность закрывает – противник видит результат второго применения функции и не может использовать его как промежуточное состояние первого (благодаря разным дополнениям ipad и opad внутренний и внешний вызовы работают с разными ключами). Кроме того, это позволяет обеспечить лучший лавинный эффект, который является признаком хорошего криптографического алгоритма. Применительно к MAC он означает, что изменение хотя бы одного бита в секретном ключе или сообщении приведет к изменению многих битов тега.
Отметим общую черту всех конструкций этой лекции. NMAC, Меркл-Дамгард и HMAC устроены по одной схеме: итеративная обработка сообщения плюс отличающееся от нее завершающее преобразование, отделяющее внутреннее состояние от выдаваемого наружу результата. Когда это завершающее преобразование пропускают, конструкция ломается одним и тем же способом.
6.6. Аутентифицированное шифрование
Как было показано в начале лекции, не зная открытый текст и ключ, противник, тем не менее, может изменить зашифрованное сообщение так, что получатель примет его как подлинное. И не важно, если противник не сможет добиться целенаправленного изменения суммы платежа. Если после дешифрования программа без дополнительных проверок приступает к исполнению документа, в котором изменены несколько битов шифртекста, то существует ненулевая вероятность, что случайное изменение приведет к корректному сообщению с другим номером счета, иной суммой платежа или измененным служебным признаком. Это очень плохо. Неважно, что в большинстве случаев получатся бессмысленные данные, и сообщение будет отвергнуто из-за ошибки формата.
Получатель не сможет отличить такое сообщение от настоящего, поскольку само шифрование никаких средств обнаружения модификации не содержит.
Это свойство называют податливостью шифртекста (malleability).
Податливым называется такой шифр или режим его применения, в котором противник способен преобразовать один корректный шифртекст в другой, причем после дешифрования получится связанный с исходным открытый текст. При этом противнику необязательно знать ни ключ, ни сами открытые данные.
Податливость сама по себе не является ошибкой реализации. Это фундаментальное свойство многих схем шифрования. Более того, существуют специальные криптографические конструкции, в которых управляемая податливость используется намеренно. Однако для защиты обычного обмена сообщениями такое поведение представляет серьезную угрозу.
Исторически проблему пытались решить путем объединения двух независимых криптографических примитивов. Сообщение сначала шифровалось для обеспечения конфиденциальности, а затем к нему добавлялся MAC. Практика показала, что безопасность такой конструкции существенно зависит от порядка выполнения операций, способа использования ключей и множества других деталей. Одни комбинации оказываются стойкими, другие допускают практические атаки.
Установлено, в частности, что из трех очевидных способов соединить шифрование и код целостности надежен, вообще говоря, лишь один. Если сначала вычислить код от открытого текста, а затем зашифровать текст вместе с кодом, получатель вынужден дешифровать сообщение прежде, чем сможет проверить его подлинность, – то есть работает с данными, происхождение которых еще не подтверждено. Если вычислить код от открытого текста и передать его рядом с шифртекстом, сам код может выдать сведения об открытом тексте. Стойким при любом стойком шифре и любом стойком коде оказывается лишь третий порядок: сначала зашифровать, затем вычислить код от полученного шифртекста, а при получении проверять код до дешифрования. Этот порядок и заложен в современные конструкции.
В результате в современной криптографии сформировался самостоятельный класс криптографических примитивов – аутентифицированное шифрование (Authenticated Encryption, AE). Если одновременно обеспечивается возможность проверки некоторых незашифрованных служебных данных (например, сетевых заголовков), говорят об аутентифицированном шифровании с дополнительными аутентифицируемыми данными (Authenticated Encryption with Associated Data, AEAD).
Главное отличие AEAD от обычного шифрования состоит в том, что результатом работы алгоритма является не только шифртекст, но и специальный аутентификационный тег. При дешифровании этот тег обязательно проверяется. Если хотя бы один бит шифртекста, дополнительной информации или самого тега изменен, проверка завершается неудачно, а открытый текст вообще не выдается приложению.
Это обстоятельство принципиально меняет модель безопасности. Получатель либо получает подлинное сообщение, либо получает сообщение об ошибке проверки. Промежуточного состояния, при котором приложение работает с измененными данными, быть не должно.
Следует обратить внимание еще на одно обстоятельство. Аутентифицированное шифрование не просто объединяет два отдельных свойства – конфиденциальность и целостность. Оно определяет новую цель безопасности, ориентированную уже на активного противника. Поэтому AEAD рассматривается как самостоятельный криптографический примитив, а не как разновидность симметричного шифрования.
Наиболее распространенными конструкциями такого рода сегодня являются AES-GCM, в котором выработка гаммы и вычисление тега объединены в одну операцию, и ChaCha20-Poly1305, применяемая там, где нет аппаратной поддержки AES. Обе относятся к режимам, требующим уникального значения IV, и здесь уместно повторить правило о запрете повторного использования пары «ключ – IV». Его нарушение в AES-GCM не просто раскрывает сумму двух открытых текстов, но и позволяет противнику вычислить внутренний ключ выработки тега, а значит, подделывать сообщения.